To metoder kan løse samme problem og likevel ikke være i samme klasse. Skal du pare givere og mottakere i et donasjonsregister, kan du prøve alle koblinger etter tur eller kjøre Ford-Fulkerson. Med personer på hver side har opptellingen koblinger å gå gjennom, mens Ford-Fulkerson gjør i størrelsesorden operasjoner. Med fire personer står det mot , og opptellingen ser billigst ut. Dobler du til åtte, står det mot .
Problem, instans og maskin
Et problem er en relasjon mellom input og output. Sortering krever at outputen er en stigende omordning av inputen, og sier ingenting om hvilke tall som kommer inn. En instans er én bestemt input, for eksempel . Problemstørrelsen er plassen en instans trenger, som regel antall elementer i den.
Kjøretiden er en funksjon av . For at den funksjonen skal si noe som gjelder på andre maskiner enn din egen, regner du i RAM-modellen: aritmetikk, sammenligning, hopp og oppslag i én celle koster én tidsenhet hver, og instruksjonene utføres etter hverandre. Heltallene har begrenset bredde, om lag bits, akkurat nok til å indeksere hele inputen. Du kan regne med større tall enn det, slik kryptografi gjør, men da holder ikke antagelsen om konstant tid per operasjon lenger.
Vekstrater
Anta ett mikrosekund per operasjon og hundre år til rådighet. Da rekker du disse problemstørrelsene:
| Kjøretid | Navn | Største på hundre år |
|---|---|---|
| logaritmisk | ||
| lineær | ||
| linearitmisk | ||
| kvadratisk | ||
| kubisk | ||
| eksponentiell | ||
| faktoriell |
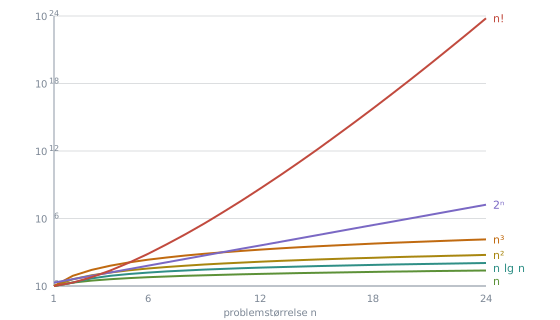
En raskere maskin hjelper mindre enn en bedre algoritme. Kjøper du en maskin som er tusen ganger raskere, flytter du de 17 faktorielle elementene til 20. Bytter du til en kvadratisk algoritme, flytter du dem til titalls millioner.
Asymptotisk notasjon
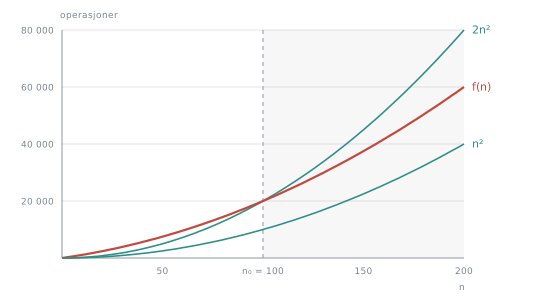
For å sammenligne vekst uten å telle enkeltoperasjoner må du se bort fra konstantfaktorer og lavere ordens ledd. Konstantfaktorene forsvinner hvis får skaleres med en konstant før sammenligningen. De lavere ordens leddene forsvinner hvis sammenligningen bare trenger å holde fra en og oppover, der det ledende leddet har tatt over. De to kravene gir definisjonen:
Ta og . Den nedre grensen holder med for alle . Den øvre holder med når , altså fra . Til venstre for ligger over , og det er tillatt, for definisjonen krever ulikheten bare fra og oppover. Altså er , og det lavere ordens leddet er borte.
De to strenge operatorene
sier at vokser høyst så raskt som , og tillater at de to vokser like raskt. og er begge sanne, men bare den første er stram. For en øvre grense som ikke er stram bruker du , og der må holde for enhver , ikke bare for én eneste. Det er en langt sterkere påstand, og den er ekvivalent med at går mot null. Så , mens .
er det samme speilvendt: en nedre grense som ikke er stram, med for enhver . Da vokser over alle grenser, og er nøyaktig det samme som .
Alle fem oppfører seg som sammenligning av to tall, og det er den raskeste veien til å huske dem:
| Utsagn | Leses som | Grensen | Som tall |
|---|---|---|---|
| vokser høyst så raskt som | endelig | ||
| vokser minst så raskt som | større enn null | ||
| vokser like raskt som | en konstant, verken eller | ||
| vokser strengt saktere enn | |||
| vokser strengt raskere enn |
Analogien holder for transitivitet og for det meste ellers, med ett unntak. To tall kan alltid sammenlignes, men to funksjoner kan mangle et forhold i det hele tatt: og er verken eller av hverandre, fordi forholdet mellom dem svinger mellom omtrent og .
Notasjonen dukker også opp midt inne i et uttrykk. Da står den for en ukjent funksjon av den oppgitte ordenen, slik at betyr « pluss en eller annen funksjon som er ». Slike ligninger leses fra venstre mot høyre, og høyresiden må være minst like generell som venstresiden. Derfor stemmer , mens er galt.
Finn det enkleste ekvivalente uttrykket, uten å tape presisjon.
Vis løsning Skjul løsning
Ta de øvre og de nedre grensene hver for seg. gir en øvre grense og ingen nedre, så den nedre er . gir en nedre grense og ingen øvre. gir begge, .
Summen av de nedre grensene er . Summen av de øvre er ubegrenset, fordi ikke setter noen tak. Da står en nedre grense alene igjen, og en nedre grense alene skrives med . Regelen står som én rad i Formelsamlingen.
Din venn Lurvik har klart å vise at to av følgende beskrivelser av kjøretiden til en algoritme er korrekte, men han husker ikke hvilke to:
Sjefen hans har bedt ham velge ut én av beskrivelsene, og nå har Lurvik bedt deg om hjelp. Hvilken av de tre velger du (nummer 1, 2 eller 3)? Forklar kort hvorfor dette er et godt valg.
Vis løsning Skjul løsning
betyr «både og ». Har Lurvik vist to av de tre, er enten nummer 3 en av dem, eller så har han vist både 1 og 2, og de to til sammen er nettopp nummer 3. Uansett stemmer , og det er den mest informative beskrivelsen, siden den gir både en øvre og en nedre grense.
Algoritme 1 sorterer tabellen . Hva er kjøretiden, som funksjon av ? Oppgi svaret i asymptotisk notasjon.
Fung-Sort(A, n)
1 for i = 1 to n
2     for j = 1 to n
3         if A[i] < A[j]
4             swap A[i] and A[j]
Vis løsning Skjul løsning
Den ytre løkka kjører ganger, og for hver av dem kjører den indre løkka ganger. Kroppen er en sammenligning og eventuelt et bytte, begge konstant tid. Ingen av løkkene har en betingelse som kan stoppe dem tidlig, så antallet iterasjoner er uansett hvordan inputen ser ut.
Insertion-Sort
Insertion-Sort sorterer slik mange sorterer kort på hånden. Den venstre delen av tabellen er sortert. Hver iterasjon løfter ut det neste elementet, nøkkelen, skyver hvert større element i den sorterte delen ett hakk mot høyre og setter nøkkelen inn i den ledige plassen.
def insertion_sort(A, n):  # indekser fra 0, læreboka teller fra 1
  for i in range(1, n):
      key = A[i]
      # Sett key inn i den sorterte delen A[0 : i]
      j = i - 1
      while j >= 0 and A[j] > key:
          A[j + 1] = A[j]
          j = j - 1
      A[j + 1] = key
return AGrønt er den sorterte delen, og boksen over tabellen holder nøkkelen.
Løkkeinvarianter
Stepperen viser at én tabell blir sortert. For å vise at enhver tabell blir
det, bruker du induksjon over iterasjonene, med en påstand om tilstanden ved
starten av hver iterasjon. Når løkka er ferdig, skal hele være sortert og
inneholde de elementene som lå der fra begynnelsen. En påstand som gir det til
slutt, er at ved starten av hver iterasjon består av de
elementene som lå der fra begynnelsen, i sortert rekkefølge. Segmentet
har begge ender med; i Python skrives det A[0 : i].
- Initialisering: før første iterasjon er , og har ett element, så det er sortert.
- Vedlikehold: iterasjonen løfter ut nøkkelen , skyver hvert større element i ett hakk mot høyre og setter nøkkelen inn i den ledige plassen. Da er sortert, og det er påstanden for neste verdi av .
- Terminering: løkka stopper etter iterasjonen med , og da gir vedlikeholdet at , altså hele tabellen, er sortert.
En slik påstand kalles en løkkeinvariant, og de tre delene er det generelle mønsteret:
Initialisering er grunntilfellet og vedlikehold er induksjonssteget. Terminering er det løkker har i tillegg: beviset er verdiløst om løkka aldri stopper.
Beviset for Insertion-Sort er svak induksjon, for vedlikeholdet bruker bare påstanden fra forrige iterasjon. Sterk induksjon antar påstanden for alle mindre tilfeller. Den passer når en algoritme kaller seg selv på instanser som er mindre enn , for eksempel halvparten: beviset for størrelse bruker da påstanden for , ikke for .
Kjøretid
Den ytre løkka går ganger uansett input. Den indre gjør et sted mellom 0
og forskyvninger, og det er der forskjellen mellom instansene ligger. Er
tabellen sortert fra før, er A[j] aldri større enn nøkkelen, while-testen
slår feil med én gang, og arbeidet er totalt. I en tilfeldig
rekkefølge er nøkkelen i snitt mindre enn halvparten av elementene foran seg, så
iterasjon gjør i snitt forskyvninger, til sammen omtrent , og
det er . Insertion-Sort bruker ekstra minne, og like
elementer beholder rekkefølgen sin.
Tabellen er sortert synkende, . Hvor mange forskyvninger gjør algoritmen?
Vis løsning Skjul løsning
I iterasjon er A[i] mindre enn hvert av de elementene foran seg, så
nøkkelen må forbi dem alle. Det er forskyvninger. Lagt sammen over
iterasjonene :
Summen er trekanttallet, et halvt rektangel med sider og . Uten konstantfaktoren og det lineære leddet står igjen.
Grenser og tilfeller
Insertion-Sort bruker på en tabell som er sortert fra før og på en som er sortert synkende, så størrelsen alene bestemmer ikke kjøretiden. For hver finnes det mange instanser, og de koster ulikt. Beste tilfelle er den billigste instansen av størrelse , verste tilfelle den dyreste, og gjennomsnittstilfellet er den forventede kostnaden når instansen trekkes tilfeldig, for sortering med alle rekkefølger like sannsynlige. Hvert av de tre er en egen funksjon av .
Hvert lyse punkt er én tilfeldig instans av størrelse med kostnaden Insertion-Sort fikk på den, og de mørke punktene er den billigste og den dyreste. De fargede kurvene er beste, gjennomsnittlige og verste tilfelle, og de stiplede kurvene er den valgte grensen.
Hvilket tilfelle du snakker om, og hvor stramt du begrenser det, er to uavhengige valg. Hver av , og kan brukes på hvert av de tre tilfellene, og og på samme måte. For Insertion-Sort gir det disse grensene:
| Tilfelle | |||
|---|---|---|---|
| Beste | |||
| Gjennomsnittlige | |||
| Verste | |||
| Ukjent input | ingen |
Utelater du tilfellet, gjelder påstanden alle instanser. «Insertion-Sort bruker » er da riktig, og «» også, mens «» er galt: på en sortert tabell bruker den .
Lurvik og Smartnes har en heftig diskusjon. Smartnes mener man kan ha en algoritme med ulik asymptotisk kjøretid i beste og verste tilfelle, der den gjennomsnittlige kjøretiden likevel er lik én av de to. Lurvik mener dette er umulig, siden gjennomsnittet av og alltid vil ligge imellom dem, altså .
Bruk et eksempel fra pensum for å vise at Smartnes har rett. Forklar kort hvorfor det er mulig.
Smartnes mener altså at average-case kan være lik enten best-case eller worst-case, selv om best-case og worst-case er forskjellige.
Vis løsning Skjul løsning
Insertion-Sort er eksempelet: beste tilfelle er , verste tilfelle er , og gjennomsnittet er også . Lurviks innvending holder for tall, men ikke for vekstrater. Målt i antall operasjoner ligger gjennomsnittet for Insertion-Sort omtrent på halvparten av verste tilfelle, og den faktoren forsvinner i notasjonen. skjuler konstantfaktorer, så to kjøretider som er ulike som tall kan ha samme asymptotiske vekst.