En tabell slår opp element nummer på konstant tid, men å sette inn et element forrest krever at alle de andre flyttes. En lenket liste setter inn forrest på konstant tid, men må følge pekere for å finne element nummer . Begge lagrer de samme elementene; det som er billig i den ene, er dyrt i den andre.
Minne, pekere og tabeller
Minnet er én lang rekke celler med hver sin adresse. En peker er en variabel som inneholder en slik adresse, altså bare et heltall som tolkes som en posisjon i minnet.
En endimensjonal tabell ligger som en sammenhengende blokk. Har blokken startadresse , elementbredde og startindeks , ligger element på adressen , og hvert steg i indeksen flytter adressen celler. Element ligger steg etter element , altså på adressen . Oppslaget er ett gangestykke og én addisjon uansett hvor stor tabellen er, og derfor koster indeksering konstant tid i RAM-modellen.
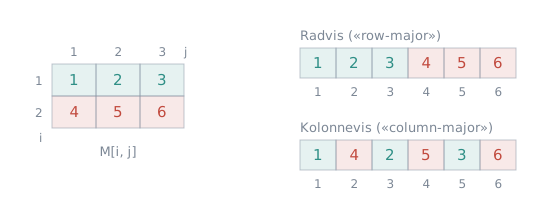
En matrise må også ned i det samme endimensjonale minnet. Radvis lagring legger rad 1, så rad 2, og så videre. Foran rad ligger da hele rader med elementer hver, og foran i rad ligger elementer, så i en matrise med kolonner ligger på plass . Kolonnevis lagring legger kolonnene etter hverandre i stedet. Et tredje alternativ er én tabell per rad, med en tabell av pekere øverst; da kan radene ha ulik lengde, såkalte jagged arrays. Alle strategiene kan utvides til flere dimensjoner.
Stakker og køer
En stakk er sist inn, først ut: alt skjer på toppen. Strukturen er en tabell og
en toppindeks, der Push legger et element på toppen og Pop tar av det
øverste, begge i konstant tid. Push på en full tabell gir overflyt, Pop på
en tom gir underflyt. Kallstakken i et kjørende program er nettopp en slik
stakk.
En kø er først inn, først ut, med innsetting bakerst og uttak forrest. Legger
du køen rett inn i en tabell, må alt flyttes hver gang noen går ut forrest.
Ringbufferen unngår det med to indekser som rykker fremover: head peker på
den første i køen og tail på neste ledige plass, og når en av dem passerer
enden, går den rundt til starten igjen.
class Queue:
  def __init__(self, m):
      self.A = [None] * m
      self.head = 0  # først i køen
      self.tail = 0  # neste ledige plass

  def enqueue(self, x):
      self.A[self.tail] = x
      self.tail = (self.tail + 1) % len(self.A)  # rundt til 0 etter siste plass

  def dequeue(self):
      x = self.A[self.head]
      self.head = (self.head + 1) % len(self.A)
return xGrønn pil er head, første i køen; rød pil er tail, neste ledige plass. En verdi som er tatt ut, blir stående nedtonet til plassen brukes igjen.
Testene for over- og underflyt er sløyfet her, som i læreboka. De trengs i
praksis: med bare head og tail ser en helt full kø ellers lik ut som en
tom.
Det følgende er hentet fra Enqueue:
1 Q[Q.tail] = x
2 if Q.tail == Q.size
3
4 else Q.tail = Q.tail + 1
Hva skal den sensurerte biten være?
Vis løsning Skjul løsning
Linje 2 tester om tail står på siste plass i tabellen. Da er neste ledige
plass den første, så tail skal gå rundt til starten. Boka bruker
1-indeksering, så starten er 1.
Q.tail = 1Dynamiske mengder
Mange algoritmer trenger bare å holde styr på en samling elementer med nøkler: sett inn, slett og søk, og når nøklene har en ordning, også minste, største, forgjenger og etterfølger. Dette kalles en dynamisk mengde, og det er funksjonalitet, ikke en bestemt datastruktur. Finnes ikke elementet du spør etter, returneres NIL. Problemstørrelsen er vanligvis antallet elementer i mengden.
En vanlig tabell kan levere funksjonaliteten, med priser som avhenger av om tabellen holdes sortert. Usortert er innsetting og sletting konstant tid, mens søk og minimum må gjennom alt. Sortert blir søket logaritmisk med binærsøk og minimum konstant, men innsetting og sletting må flytte elementer og blir lineære. En lenket liste setter inn og sletter midt i en rekkefølge uten å flytte noe, og har ingen fast størrelse. En hashtabell gjør søket forventet konstant. For de ordnede operasjonene er søketrær verktøyet.
Lenkede lister
En lenket liste består av noder som peker på neste node, og i en dobbeltlenket liste også på forrige. Lista selv er bare en peker til hodet.
Søk følger pekerne fra hodet til nøkkelen dukker opp eller lista tar slutt, og koster i verste fall. Til gjengjeld er innsetting og sletting konstant tid, for nodene blir liggende der de er, og bare pekerne endres. Å sette inn en node etter en annen er fire pekertilordninger; å slette en node er to, der naboene settes til å peke på hverandre og noden hoppes over. Konstant tid forutsetter at du allerede står ved noden. Skal den først finnes, betaler du det lineære søket i tillegg.
def insert_after(a, x):
  x.prev = a
  x.next = a.next
  a.next.prev = x
  a.next = x

def delete(x):
  x.prev.next = x.next
x.next.prev = x.prevRød peker settes i steget, oransje leses.
Grensetilfellene er sløyfet her også: står noden først eller sist i lista, finnes bare den ene naboen.
Sammenlign lenkede lister (linked lists) med tabeller (arrays). Hvilke fordeler og ulemper har de, sammenlignet med hverandre? Forklar.
Vis løsning Skjul løsning
En tabell ligger sammenhengende i minnet, så element nummer finnes med et regnestykke på adressen, i konstant tid. Prisen er at innsetting og sletting inne i tabellen må flytte alle elementene bak, altså i verste tilfelle, og at størrelsen er fast: blir tabellen full, må en større allokeres og alt kopieres.
En lenket liste holder elementene som noder med pekere. Har du en peker til noden, setter du inn eller sletter i konstant tid uten å flytte noe, og lista vokser fritt. Til gjengjeld finnes ikke element nummer uten å følge pekere, så oppslag og søk er , og hver node koster ekstra minne til pekerne.
Hashtabeller
Den enkleste formen for oppslag er direkte adressering: bruk nøkkelen selv som indeks, slik at inneholder elementet med nøkkel . Søk, innsetting og sletting er én tabelloperasjon hver. Prisen er at tabellen må være like stor som mengden av mulige nøkler, ikke antallet du faktisk lagrer.
En hashtabell beholder ideen, men kjører nøkkelen gjennom en hashfunksjon som krymper den til en gyldig indeks . Den enkleste er . I praksis brukes gjerne funksjoner som blander bitene bedre, som multipliser-og-skift, og strenger hashes ved å kombinere tegnene aritmetisk. En god hashfunksjon gir alltid samme indeks for samme nøkkel, sprer nøklene så indeksene ser tilfeldig fordelt ut og regnes ut i konstant tid.
Med flere mulige nøkler enn plasser må to nøkler før eller siden dele indeks, en kollisjon. Kjeding løser det ved å la hver plass i tabellen holde en lenket liste. Innsetting setter elementet forrest i lista på plass og koster ; søk hasher nøkkelen og leter lineært gjennom lista på plassen.
Å regne ut og slå opp plassen tar konstant tid, så resten av søket er letingen gjennom lista på plassen. Fordeler hashfunksjonen nøklene jevnt og uavhengig, får hver av de listene i snitt elementer. Det tallet er belastningsfaktoren . Et søk som ikke finner nøkkelen, går gjennom en hel liste, forventet elementer, så søket tar forventet tid. Et søk som finner nøkkelen, stopper i snitt omtrent halvveis i lista og har samme grense.
Forventningen er ingen garanti. Ingenting hindrer at alle nøklene havner på samme plass, og da er søket et lineært søk i én liste, .
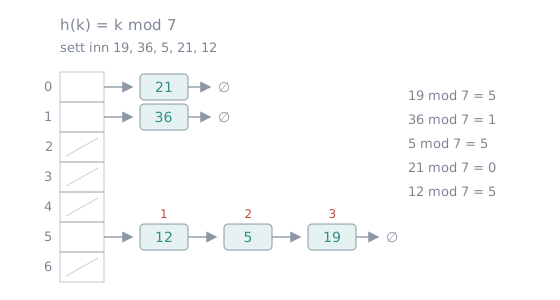
Sett inn nøklene 19, 36, 5, 21 og 12, i den rekkefølgen, i en tom hashtabell med plasser og kjeding. Hvor havner nøklene, og hvor mange nøkler må et søk etter 19 sammenligne?
Vis løsning Skjul løsning
, , , og . Plass 0 får 21 og plass 1 får 36, mens 19, 5 og 12 alle havner på plass 5. Innsetting skjer forrest i lista, så kjeden på plass 5 blir , med den sist innsatte nøkkelen først. Et søk etter 19 hasher til plass 5 og må gjennom hele kjeden: først 12, så 5, så 19.
Er nøkkelmengden statisk, kjent på forhånd og uforanderlig, kan du bygge en tabell der ingen nøkler kolliderer. Det kalles perfekt hashing og gir søk i garantert konstant tid, ikke bare forventet. Et typisk bruksområde er de reserverte ordene i en kompilator.
Tabellen har to nivåer. Først hashes de nøklene inn i plasser, med kollisjoner som vanlig. Plass , som fikk nøkler, får så sin egen sekundærtabell med plasser og sin egen hashfunksjon, valgt slik at ingen av de nøklene kolliderer der. En slik funksjon er lett å finne. De nøklene danner færre enn par. Trekkes funksjonen tilfeldig fra en familie der hvert par kolliderer med sannsynlighet høyst , er forventet antall kollisjoner derfor under . Da er sannsynligheten for minst én kollisjon også under , siden hver trekning med kollisjon bidrar med minst 1 til forventningen. Du trekker på nytt til funksjonen er kollisjonsfri, i snitt færre enn to ganger.
Et søk regner ut to hashverdier og sammenligner med én nøkkel, så det tar konstant tid uansett input. Sekundærtabeller på plasser ser dyre ut, men med en jevn fordeling på første nivå er summen av alle forventet under , så tabellene tar plass til sammen.
Kostnadene så langt, samlet:
| Struktur | Søk | Innsetting | Sletting | Minimum |
|---|---|---|---|---|
| Usortert tabell | ||||
| Sortert tabell | ||||
| Lenket liste | ||||
| Hashtabell med kjeding | forventet |
Hvordan vurderer du følgende hashfunksjon? Forklar kort.
Spørsmålet er altså hvor god eller dårlig hashfunksjonen er, og hvorfor. Her er et positivt heltall og er størrelsen på hashtabellen.
Vis løsning Skjul løsning
En god hashfunksjon sprer nøklene jevnt over alle posisjonene. Denne gjør det motsatte. vokser så fort at bare nøklene med får hver sin posisjon, og det er færre enn av dem. Alle nøkler med får og kolliderer i samme posisjon. Nesten hele tabellen står tom mens én lenke får nesten alle elementene, og søk blir i stedet for forventet konstant tid.
Dynamiske tabeller
Blir en stakk eller en kø full, må den få mer plass: alloker en større tabell, kopier alt over, og fortsett der. En hashtabell med kjeding blir aldri full, men vokser med , så den trenger også en større tabell for at søket skal holde seg forventet konstant. Ved utvidelsen hashes hver nøkkel på nytt med en funksjon for den nye størrelsen, i konstant tid per nøkkel, så den koster like mye som en kopiering. Kopieringen tar lineær tid, så den bør skje sjelden. Med tabelldobling allokeres dobbelt så stor plass hver gang tabellen er full, eller for hashtabellen hver gang når en fast grense.
Én enkelt innsetting kan da koste lineær tid, men de dyre innsettingene blir sjeldnere jo større tabellen blir. Tell derfor det totale arbeidet over mange innsettinger.
En dynamisk tabell starter med plass til ett element og dobles hver gang den er full. Tell operasjonene for innsettinger, med én operasjon per innsetting og én per kopiert element.
Vis løsning Skjul løsning
Hver innsetting skriver ett element: 16 operasjoner. Kopiering skjer når tabellen er full, ved størrelsene 1, 2, 4 og 8, og koster like mange operasjoner som størrelsen:
Summen er toerpotens-summen, som alltid er én mindre enn neste toerpotens, her . Totalt blir det operasjoner.
For innsettinger skjer kopieringen ved størrelsene , der er den største toerpotensen under . Kopieringsarbeidet er da , og det er mindre enn , ettersom . Med de skrivingene i tillegg blir totalen under , så hver innsetting koster i snitt færre enn 3 operasjoner. For gir grensen , og tellingen over ga .
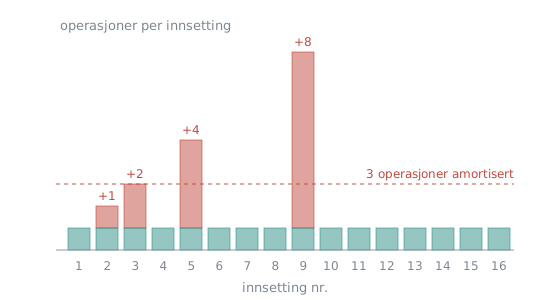
Å regne ut det totale arbeidet for en hel operasjonsfølge og dele på antallet operasjoner heter aggregert analyse. Det er den enkleste formen for amortisert analyse, og den viser at tabelldobling koster amortisert konstant tid per innsetting. Analysen antok ingen sannsynlighet og ingen snill input: amortisert kjøretid er et snitt over operasjonene i én følge, i verste fall. Gjennomsnittstilfellet er noe annet, et snitt over instanser med en sannsynlighetsfordeling.
Multipop på en stakk
Multipop popper inntil elementer av en stakk. Én Multipop kan koste
, så operasjoner ser ut som . Men hvert element må
pushes før det kan poppes, så Push og Multipop gjør totalt
arbeid, amortisert per operasjon.