Et rotfast tre er en rekursiv dekomponering: hver node er rota i sitt eget deltre. Da kan du kreve noe av alle deltrærne på én gang. I et binært søketre er alt i venstre deltre mindre enn rota og alt i høyre deltre større. Egenskapen gir søk, innsetting og etterfølger i tid proporsjonal med høyden. I en haug kreves bare at rota er størst, og kravet gjelder rekursivt for hvert deltre. Haugegenskapen gir mindre funksjonalitet, men haugen er billigere å bygge og holder seg balansert av seg selv, så den brukes som prioritetskø og til å sortere.
Rotfaste trær
Et fritt tre er en sammenhengende graf uten sykler. Det har nøyaktig én sti mellom hvert par av noder, og . Velger du ut én node som rot, får du et rotfast tre, og da har kantene retning: rota har ingen forelder, hver annen node har nøyaktig én, og nodene rett under en node er barna dens.
Treet i figur 1 har rota 7. Barna til 7 er 5 og 6, og barna til 5 er 1, 2, 3 og 4. En node uten barn er en løvnode, som 1 og 6, og de andre er indre noder, her 5 og 7. Dybden til en node er antall kanter opp til rota, så 1 har dybde 2. Høyden til treet er den største dybden, her 2. Deltreet med rot er og alt under den, så deltreet med rot 5 har fem noder.
Et binærtre har to barneposisjoner per node, venstre og høyre, og en av dem kan stå tom. Du vet altså hvilket barn som mangler. Et komplett binærtre er fullt, alle indre noder har to barn, og alle løvnodene har samme dybde. Har treet høyde , har nivåene noder. Løvnodene på nederste nivå er , og nivåene over har noder til sammen, så treet har noder i alt. Da er , og . Balansert binærtre defineres på flere måter, men alle gir logaritmisk høyde.
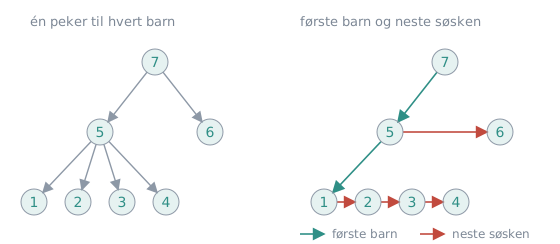
En node i et binærtre har pekere left og right, og gjerne p til
forelderen. Kan en node ha vilkårlig mange barn, holder det likevel med to
pekere: én til første barn og én til neste søsken. Barna til en node er da en
lenket liste som starter i første barn.
Binære søketrær
Hver node har en nøkkel key. Du kan anta at nøklene er forskjellige.
Egenskapen gjelder for hver node, ikke bare rota, så hvert deltre er selv et binært søketre. Den er binærsøk lagret som datastruktur: fra hver node vet du hvilken side en nøkkel må ligge på.
Inorder-Tree-Walk skriver ut venstre deltre, så noden, så høyre deltre, rekursivt fra rota. Egenskapen gir at utskriften er sortert: alt til venstre kommer før noden og er mindre, alt til høyre kommer etter og er større. Hver node besøkes én gang, så det tar . Preorder og postorder skriver ut noden før eller etter de to rekursive kallene i stedet for mellom dem.
Tree-Search sammenligner nøkkelen med nøkkelen i . Er de like, er svaret. Er mindre, kan den bare ligge i venstre deltre, så du søker videre der, ellers i høyre. Treffer du nil, finnes ikke . Ingenting skjer etter det rekursive kallet, så søket skrives like gjerne som en løkke. Stien går nedover fra rota og er høyst lang, så søket koster .
Tree-Insert søker etter nøkkelen til den nye noden til søket treffer nil, og henger på der. Under søket følger ett steg bak , så når blir nil, er noden som skal bli forelder. Er nil, var treet tomt, og blir rot. Ellers blir venstre eller høyre barn av etter samme test som i søket. En ny node blir alltid en løvnode.
def tree_insert(T, z):
  x, y = T.root, None
  while x is not None:
      y = x
      if z.key < x.key:
          x = x.left
      else:
          x = x.right
  z.p = y
  if y is None:
      T.root = z
  elif z.key < y.key:
      y.left = z
  else:
      y.right = z

def inorder_tree_walk(x):
  if x is not None:
      inorder_tree_walk(x.left)
      print(x.key)
inorder_tree_walk(x.right)Et binært søketre bygd med Tree-Insert av nøklene i raden under, i den rekkefølgen de står. Vannrett posisjon er nøkkelens plass i sortert rekkefølge. Rødt er eller den nye noden, oransje er , og grønt er skrevet ut av Inorder-Tree-Walk.
Tree-Minimum følger left til det ikke går lenger, for alt i et høyre deltre
er større enn noden over. Tree-Maximum følger right. Etterfølgeren
til er noden med den minste nøkkelen som er større enn nøkkelen til ,
altså den neste i Inorder-Tree-Walk. Har et høyre deltre, er etterfølgeren
minimum der. Har ikke noe høyre deltre, er maksimum i et deltre, og
etterfølgeren er den nærmeste noden over som har i sitt venstre
deltre. Gå oppover så lenge du kommer fra et høyre barn. Forgjengeren finnes symmetrisk. Alle
fire følger én sti opp eller ned, .
def tree_search(x, k):
  while x is not None and k != x.key:
      x = x.left if k < x.key else x.right
  return x

def tree_minimum(x):
  while x.left is not None:
      x = x.left
  return x

def tree_successor(x):
  if x.right is not None:
      return tree_minimum(x.right)
  y = x.p
  while y is not None and x is y.right:
      x, y = y, y.p
  return y
Tree-Delete skiller på hvor mange barn har. Har høyst ett barn, kobles barnet inn der sto, med hjelpeprosedyren Transplant. Har to barn, er etterfølgeren minimum i høyre deltre og har ikke noe venstre barn, så kan kobles ut på samme måte og settes inn der sto. Tree-Delete følger også én sti, .
| Operasjon | Kjøretid |
|---|---|
| Inorder-Tree-Walk | |
| Tree-Search, Tree-Minimum, Tree-Maximum | |
| Tree-Successor, Tree-Predecessor | |
| Tree-Insert, Tree-Delete |
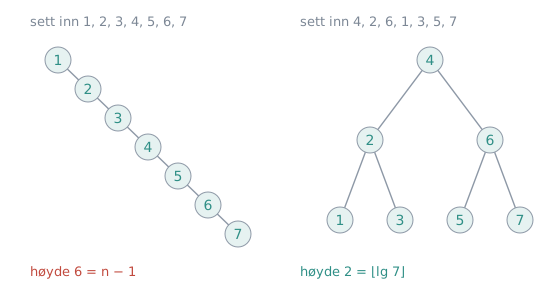
Alle operasjonene unntatt traverseringen koster altså , og høyden avhenger av innsettingsrekkefølgen. Settes inn i stigende rekkefølge, blir hver ny nøkkel høyre barn av den forrige, og treet er en kjede med høyde . Da koster søk , som i en lenket liste. Settes de samme nøklene inn i rekkefølgen , er treet komplett med høyde .
Med en tilfeldig innsettingsrekkefølge finner du den forventede dybden ved å telle sammenligninger. Når settes inn, sammenlignes den med hver node på stien fra rota ned til forelderen, og den stien har like mange noder som dybden får. Summen av dybdene er altså antall sammenligninger i hele byggingen. Rota deler de senere nøklene i mindre og større, og hvert deltre deler sine videre på samme måte. Det er de samme sammenligningene som Quicksort gjør når pivoten i hvert segment er den nøkkelen som ble satt inn først. I en tilfeldig permutasjon er den pivoten tilfeldig, og da gjør Quicksort forventet sammenligninger. Snittet av dybdene er derfor forventet , og det er kostnaden til et søk etter en tilfeldig nøkkel. Høyden er den største dybden, og en finere regning viser at også forventet høyde er . Verste tilfelle er fortsatt lineært. Det finnes søketrær som balanserer seg selv etter hver innsetting og sletting i logaritmisk tid, for eksempel rød-svarte trær, og de garanterer .
Start med et tomt binært søketre, og sett så inn følgende verdier, i rekkefølge, med Tree-Insert:
Utfør deretter Inorder-Tree-Walk på rotnoden i det resulterende treet. Hva skriver algoritmen ut?
Du skal her kun svare med output fra algoritmen.
Vis løsning Skjul løsning
Du kan bygge treet: 7 blir rot, 1 går til venstre, 0 til venstre for 1, 5 til høyre for 1, og så videre. Men det trengs ikke. Inorder-traversering av et binært søketre besøker alltid nodene i sortert rekkefølge, uansett hvilken rekkefølge de ble satt inn i.
Om du bygger et binært søketre av elementer, hva blir kjøretiden til søk i treet etterpå, i beste og verste tilfelle, og i gjennomsnitt? Forklar.
Du bruker altså Tree-Insert for å sette inn ett og ett element, der treet til å begynne med er tomt, og vi er ute etter kjøretiden til Tree-Search på det ferdige treet (best-case, worst-case og average-case). Du kan anta at elementene er tallene i en (uniformt) tilfeldig rekkefølge.
Vis løsning Skjul løsning
Søk følger én sti nedover fra rota og koster , der er høyden.
Beste tilfelle er uansett form på treet: nøkkelen du søker etter kan sitte i rota.
Verste tilfelle er et helt ubalansert tre, som når elementene kom i sortert rekkefølge, og da er høyden . Et søk etter en av de nederste nodene koster .
I gjennomsnitt, med tilfeldig innsettingsrekkefølge, er høyden , så et søk koster . Et søk koster også : et binærtre har høyst noder over dybde , så mer enn halvparten av nodene ligger på dybde eller dypere.
Hauger
En haug er et binærtre som er komplett ned til nest
nederste nivå, og der det nederste nivået er fylt fra venstre. Nummererer du
nodene nivå for nivå med rota som 1, har nivå numrene til
. Node på nivå har noder foran seg på nivået, og
barna til dem, to per node, står først på nivået under. Det første barnet til
får da nummeret , og det andre . Barna
og har begge forelderen , så forelderen til en node er
. Numrene er indekser
i en tabell, så haugen trenger ingen pekere. er treet, Left,
Right og Parent er regnestykker, og haugstørrelsen size sier hvor mye av
tabellen som er haug.
Haugegenskapen sier ingenting om rekkefølgen mellom søsken, så en haug er langt fra sortert. Sorteringsgrensen gjelder når svaret er én bestemt av rekkefølger, og den gjelder derfor ikke for å bygge en haug.
Har haugen høyde , er nivåene fulle og har noder til sammen, og det nederste nivået har fra 1 til noder. Da er , og .
Max-Heapify reparerer en haug der bare kan være for liten, altså der begge deltrærne under er maks-hauger. Finn den største av og de to barna. Er det , er alt i orden. Ellers bytt med det største barnet, så den nye rota er større enn begge, og reparer deltreet der det mindre elementet havnet, rekursivt. Elementet synker til det er større enn begge barna eller er en løvnode. Byttet må være med det største barnet, ellers blir den nye rota mindre enn det andre barnet. Stien går nedover, høyst steg, så Max-Heapify koster .
Node har et venstre barn bare når , så nodene fra til har ingen barn. De er løvnoder og dermed maks-hauger alene. Build-Max-Heap kaller Max-Heapify på de indre nodene fra og ned til 1, nedenfra og opp i treet. Når turen kommer til , er barna og løvnoder eller allerede behandlet, for de har høyere numre. Begge deltrærne under er da maks-hauger, så forutsetningen for Max-Heapify holder, og etter kallet er også deltreet med rot en maks-haug.
def max_heapify(A, i, size):
  l, r = 2 * i + 1, 2 * i + 2  # indekser fra 0: rota er A[0]
  m = i
  if l < size and A[l] > A[m]:
      m = l
  if r < size and A[r] > A[m]:
      m = r
  if m != i:
      A[i], A[m] = A[m], A[i]
      max_heapify(A, m, size)

def build_max_heap(A, n):
  for i in range(n // 2 - 1, -1, -1):
max_heapify(A, i, n)Tabellen tegnet som tre og som celler, med indekser fra 0 som i koden. Stiplede noder har Build-Max-Heap ikke nådd ennå. Rødt er noden Max-Heapify står på eller de to som bytter. Barna den sammenlignes med er oransje, og det største av dem er fylt.
kall til Max-Heapify som hvert koster , gir . Det er riktig, men ikke stramt, for nesten alle kallene er langt nede i treet, der det er lite å synke. Høyden til en node er høyden til deltreet med noden som rot, og en node med høyde synker høyst steg. Følger du venstre barn ganger fra node , kommer du til node , det laveste nummeret nivåer under , så har høyde minst nøyaktig når . Nodene til har derfor høyde minst , og de med høyde nøyaktig er nodene fra til , altså høyst av dem.
Arbeidet per node vokser lineært med høyden, men antallet noder synker eksponentielt med den, og den geometriske faktoren dominerer. Hver indre node besøkes, så gjelder også, og Build-Max-Heap er .
Hvorfor rekken konvergerer
For er . Med er summen , så .
Prioritetskøer
En prioritetskø holder en mengde elementer med nøkler og støtter Insert, Maximum, Extract-Max og Increase-Key, eller min-variantene. Nøklene er prioriteter, så duplikater er vanlige, i motsetning til i en oppslagstabell. En lenket liste gir innsetting i konstant tid, men lineær tid for å finne maksimum. En maks-haug gir alle fire i logaritmisk tid eller bedre.
Max-Heap-Maximum er , i konstant tid. Max-Heap-Extract-Max tar vare på rota, flytter det siste elementet i haugen opp i rota, minsker haugstørrelsen med én og kaller Max-Heapify på rota, for nå er rota det eneste som kan være feil. Å forskyve resten av tabellen ett hakk i stedet ville kostet og gitt hvert element en ny forelder.
Max-Heap-Increase-Key gir elementet på plass en større nøkkel. Nå kan det være større enn forelderen, så det stiger: bytt med forelderen så lenge den er mindre. Max-Heap-Insert legger det nye elementet sist i haugen med nøkkel og øker nøkkelen til den riktige verdien, så det stiger på plass. Synking og stiging følger begge én sti i treet, . Increase-Key trenger indeksen til elementet, så er elementene objekter, må haugen bokføre hvor hvert av dem står, og oppdatere det ved hvert bytte.
from math import inf

def max_heap_maximum(A):
  if len(A) < 1:
      raise ValueError("heap underflow")
  return A[0]

def max_heap_extract_max(A):
  m = max_heap_maximum(A)
  A[0] = A[-1]
  A.pop()
  max_heapify(A, 0, len(A))
  return m

def max_heap_increase_key(A, i, key):
  if key < A[i]:
      raise ValueError("new key is smaller")
  A[i] = key
  # indekser fra 0: forelderen til i er (i - 1) // 2
  while i > 0 and A[(i - 1) // 2] < A[i]:
      A[i], A[(i - 1) // 2] = A[(i - 1) // 2], A[i]
      i = (i - 1) // 2

def max_heap_insert(A, key):
  A.append(-inf)
max_heap_increase_key(A, len(A) - 1, key)| Operasjon | Kjøretid |
|---|---|
| Max-Heapify | |
| Max-Heap-Maximum | |
| Max-Heap-Extract-Max | |
| Max-Heap-Increase-Key | |
| Max-Heap-Insert | |
| Build-Max-Heap |
Heapsort
Sortering ved utvelgelse plukker ut det største av de usorterte elementene og legger det bakerst, ganger, og bruker per plukk. Heapsort gjør det samme med en maks-haug som usortert del, så hvert plukk er en Extract-Max. Bygg haugen av hele . Så, for fra ned til 2: bytt rota med , minsk haugstørrelsen med én og kall Max-Heapify på rota.
Invarianten er at er de største elementene, sortert, og at er en maks-haug. Rota er det største elementet i , så byttet legger det på plass , rett foran de elementene som allerede er sortert. Etter byttet er bare den nye rota feilplassert i , og Max-Heapify flytter den på plass. Sorteringen skjer på plass: haugen ligger foran i tabellen, og den sorterte delen vokser bakfra.
def heapsort(A, n):
  build_max_heap(A, n)
  size = n
  for i in range(n - 1, 0, -1):
      A[0], A[i] = A[i], A[0]
      size = size - 1
max_heapify(A, 0, size)Tabellen tegnet som tre og som celler, med indekser fra 0 som i koden og haugen bygd på forhånd. Rødt er noden Max-Heapify står på eller de to som bytter. Barna den sammenlignes med er oransje, og grønt er utenfor haugen og ferdig sortert.
Byggingen koster , og så følger kall til Max-Heapify på hver, altså . Heapsort er sammenligningsbasert, så sorteringsgrensen gir i verste tilfelle, og verste tilfelle er derfor . Er alle elementene like, stopper hvert Max-Heapify med en gang, og beste tilfelle er . Med forskjellige elementer er også beste tilfelle , så sortert input gjør ikke Heapsort raskere.
| Algoritme | Verste | Snitt | Beste |
|---|---|---|---|
| Insertion-Sort | |||
| Merge-Sort | |||
| Heapsort | |||
| Quicksort | |||
| Counting-Sort | |||
| Radix-Sort | |||
| Bucket-Sort |
Tabellen representerer en haug. Hvordan ser tabellen ut etter første iterasjon av Heapsort?
Du skal altså utføre den første av iterasjoner. Svar ved å liste opp elementene i tabellen. Oppgi hele tabellen, inkludert deler som ikke lenger er en del av haugen.
Vis løsning Skjul løsning
Første iterasjon bytter rota med siste element og krymper haugen med én: med haugstørrelse 8. Så synker 6 med Max-Heapify. Barna til 6 er 8 og 5, så 6 bytter med 8: . Barna til 6 er nå 7 og 1, så 6 bytter med 7: . Barna til 6 på plass 4 ville vært plass 8 og 9. Plass 9 er utenfor haugen og 4 er mindre enn 6, så 6 blir stående.