Å traversere en graf er å besøke nodene du har oppdaget. I starten har du bare oppdaget startnoden, men hver gang du besøker en node, oppdager du naboene dens. Slik når du alle nodene som kan nås fra startnoden. Traversering er nyttig i seg selv, og mange grafalgoritmer bygger på den. Læreboka kaller traversering søk (search), og derfor heter de to algoritmene bredde-først-søk og dybde-først-søk.
Grafrepresentasjoner
En graf har nodene og kantene . I en rettet graf går kanten fra til , og er en ut-nabo av . I en urettet graf går kanten begge veier. Kjøretiden til en grafalgoritme har to parametre, og inne i asymptotisk notasjon står for og for , så betyr .
Med nabolister har hver node sin egen liste: inneholder ut-naboene til . Grafen er altså en tabell med én liste per node, og ikke én liste. I en rettet graf står kanten bare i lista til , så listene har til sammen elementer (). I en urettet graf står den i begge listene, og summen blir . Plassen er . En nabomatrise er en -tabell der når er en kant, og 0 ellers. Den tar plass uansett hvor mange kanter grafen har, og for en urettet graf er den symmetrisk.
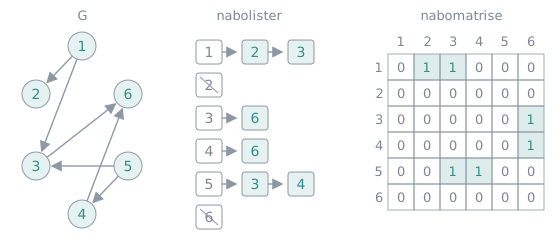
En vektet graf lagrer vekten sammen med i lista til , eller som i matrisen. Tabellen viser hva de vanligste operasjonene koster.
| Operasjon | Nabolister | Nabomatrise |
|---|---|---|
| Plass | ||
| Er en kant? | Søk i | |
| Alle ut-naboene til | ||
| Alle kantene |
Nabomatrisen egner seg til direkte oppslag, og nabolistene til traversering. Det sies ofte at matrisen er raskere og listene tar mindre plass, men det stemmer bare delvis. Listene tar mindre plass når grafen har få kanter. Har den nær kanter, tar begge . Algoritmene i læreboka bruker nabolister med mindre de trenger raske oppslag, og listene kan gjerne byttes ut med hashtabeller.
Traversering
Start i node 5 i figur 1, med 5 alene på en liste. Du tar 5 av lista, besøker den og fører opp naboene 3 og 4. Du besøker 3 og fører opp 6. Når du besøker 4, står 6 alt på lista. Du besøker 6, og lista er tom. Nodene 5, 3, 4 og 6 er besøkt, og 1 og 2 kan ikke nås fra 5.
Lista er en huskeliste med noder som er oppdaget, men ikke besøkt. Å besøke en node er å ta den av lista og føre opp naboene den har. Når lista er tom, er alle nodene som kan nås fra startnoden, besøkt. En node på en sti fra startnoden føres nemlig opp senest når noden foran den på stien besøkes, og alt som føres opp, tas av lista før den er tom. Hvilken node som tas av lista først, bestemmer hvilken traversering det blir.
Algoritmene i læreboka holder styr på hvilke noder som er oppdaget og besøkt, med farger. En node er hvit før den er oppdaget, grå når den er oppdaget, men ikke ferdig, og svart når den er ferdig. Uten fargene ville en sykel sendt traverseringen rundt og rundt. Med dem behandles hver node én gang, på samme måte som memoisering løser hver delinstans én gang. Når oppdages langs kanten , får den forgjengeren . Kantene danner et traverseringstre med startnoden som rot.
Dybde-først-søk
Dybde-først-søk (DFS) går alltid videre fra den nyeste noden den har oppdaget. DFS-Visit gjør grå og går gjennom naboene. Møter den en hvit nabo , setter den og kaller seg selv på med en gang. Først når alle naboene er sett, blir svart. Kallstakken er huskelista. DFS farger alle nodene hvite og kaller DFS-Visit fra hver node som fortsatt er hvit, i rekkefølge. Den når dermed hele grafen, og hvert kall fra hovedløkka gir et nytt tre. Til sammen blir trærne en dybde-først-skog.
DFS gir hver node to tider fra en felles teller time: starttiden når
oppdages og blir grå, og sluttiden når er ferdig og blir svart.
Telleren øker med 1 hver gang, så tidene er heltallene fra 1 til , og
.
def dfs(G):  # G[u] er lista med ut-naboene til u
  color = {u: "white" for u in G}
  pi = {u: None for u in G}
  d, f = {}, {}  # u.d og u.f er d[u] og f[u]
  time = 0

  def dfs_visit(u):
      nonlocal time
      time += 1
      d[u] = time
      color[u] = "gray"
      for v in G[u]:
          if color[v] == "white":
              pi[v] = u
              dfs_visit(v)
      time += 1
      f[u] = time
      color[u] = "black"

  for u in G:
      if color[u] == "white":
          dfs_visit(u)
return d, f, piGrafen fra forelesningen. Hver node har fargen DFS har gitt den og tidene d/f. Tre-kantene har et bånd, og en annen undersøkt kant har en bokstav: B for bakoverkant, F for foroverkant og K for krysskant. Under grafen er hver node en stolpe fra til , med én rad per dybde i treet, og de grå stolpene er nodene på kallstakken.
DFS-Visit kalles én gang per node, for den kalles bare på hvite noder, og noden blir grå med en gang. Hvert kall går gjennom nabolista én gang, så alle kallene undersøker til sammen kanter i en rettet graf. Med initialiseringen blir kjøretiden ().
Parentesteoremet og hvit-sti-teoremet
Skriv «(u» når oppdages og «u)» når er ferdig. Da blir parentesene riktig nøstet. Kallet på en node ligger inni kallene på forfedrene, så noden oppdages etter dem og blir ferdig før dem.
I DFS-stepperen er hver node en stolpe fra til , og to stolper overlapper bare når den ene ligger inni den andre. er altså en ekte etterkommer av hvis og bare hvis ().
Er en etterkommer, oppdages den etter , og det gjør alle nodene på trestien mellom dem, så de er hvite ved . Omvendt, la være den første noden på en hvit sti fra som ikke blir en etterkommer. Noden før på stien er eller en etterkommer av , og den blir ikke ferdig før den har undersøkt kanten til . Da oppdages mens er grå, og etter parentesteoremet er den en etterkommer likevel.
Kantklassifisering
DFS deler kantene i fire typer etter dybde-først-skogen. Fargen til når kanten undersøkes, avgjør typen.
| Kant | Går til | er |
|---|---|---|
| Tre-kant | et barn i dybde-først-skogen | hvit |
| Bakoverkant | en forfader, eller selv | grå |
| Foroverkant | en etterkommer, uten å være en tre-kant | svart, |
| Krysskant | en node som verken er forfader eller etterkommer | svart, |
En grå node ligger på kallstakken, så den er en forfader til , og kanten lukker en sykel. Omvendt, har grafen en sykel, la være den første noden i sykelen som DFS oppdager, og noden foran i sykelen. Ved er resten av sykelen en hvit sti fra til , så blir en etterkommer av etter hvit-sti-teoremet, og kanten blir en bakoverkant. En rettet graf har altså en sykel hvis og bare hvis DFS finner en bakoverkant.
I en urettet graf er hver kant en tre-kant eller en bakoverkant. Er , er hvit ved , og kanten er en hvit sti fra til . Etter hvit-sti-teoremet blir da en etterkommer av og ferdig mens er grå. Undersøkes kanten første gang fra , er hvit, og kanten blir en tre-kant. Undersøkes den første gang fra , er fortsatt grå, og kanten blir en bakoverkant.
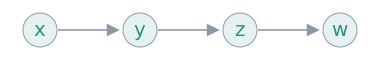
Utfør DFS på grafen nedenfor, slik at første kall til DFS-Visit starter i node . Hva blir og (discovery time og finish time) for hver node ?
Oppgi svaret som to lister med 4 tall på hver sin linje, som f.eks.:
1, 2, 4, 7
5, 6, 3, 8
Første linje er , , , , i rekkefølge, og andre linje er , , , .
Hint: Husk at DFS starter en ny dybde-først-traversering med DFS-Visit fra hver eneste node som ikke allerede er besøkt.
Vis løsning Skjul løsning
oppdages først, med . Kanten gir , og gir . har ingen kanter ut og blir ferdig med , og så blir og . Hovedløkka i DFS fortsetter med nodene som er hvite, og det er bare . Den får , kanten går til en svart node, og .
7, 1, 2, 3 og 8, 6, 5, 4.
Topologisk sortering
En rettet asyklisk graf, en DAG, er en rettet graf uten sykler. En topologisk sortering av en DAG er en rekkefølge av nodene der alle kantene peker fremover: for hver kant kommer før . Kantene kan være avhengigheter, som at buksa må på før skoene. Har grafen en sykel, finnes ingen slik rekkefølge, for en av kantene i sykelen må peke bakover.
En klassisk metode tar ut en node uten inn-kanter, fjerner den fra grafen og gjentar. Topological-Sort bruker i stedet DFS. Hver gang en node blir ferdig, settes den først i en lenket liste, så lista ender opp sortert etter synkende sluttid. Innsettingen tar konstant tid, og alt tar .
Synkende sluttid er riktig fordi for hver kant (). Når DFS undersøker kanten, er hvit, svart eller grå. Er hvit, blir den en etterkommer av og ferdig før . Er svart, er den alt ferdig. Er grå, er kanten en bakoverkant, og grafen har en sykel, så i en DAG er aldri grå. Argumentet bruker ingenting om rekkefølgen i hovedløkka og nabolistene. En annen rekkefølge kan gi en annen sortering, men den er like riktig.
Koden trenger ikke tidene, bare rekkefølgen nodene blir ferdige i.
from collections import deque

def topological_sort(G):
  color = {u: "white" for u in G}
  order = deque()  # appendleft setter inn først i O(1)

  def visit(u):
      color[u] = "gray"
      for v in G[u]:
          if color[v] == "white":
              visit(v)
      color[u] = "black"
      order.appendleft(u)

  for u in G:
      if color[u] == "white":
          visit(u)
return list(order)Påkledningen fra forelesningen: en kant betyr at må på før . Hver boks viser plagget og tidene d/f. Til høyre står lista order med det første plagget øverst, og buene ved siden av den er kantene ut av plaggene i lista.
Vurder følgende utsagn om Topological-Sort:
Nodene sorteres etter synkende starttid (discover-time).
Stemmer dette? Svar ja eller nei og forklar kort.
Vis løsning Skjul løsning
Se på grafen med nodene 2 og 3 og kanten . Starter DFS i 2, blir 3 en etterkommer med og , og synkende starttid setter 3 foran 2. Kanten peker da bakover. Det som er trygt, er sluttiden: for hver kant , uansett hvor DFS starter. Stigende starttid er ikke trygt heller, for starter DFS i 3, får 3 den laveste starttiden.
Memoisering er DFS
Memoisering i dynamisk programmering er DFS i delinstansgrafen, men mot kantene: et kall går fra en instans til delinstansene den bygger på. Et kall blir ferdig først når alle disse er løst, og en delinstans som alt er løst, er svart og slås bare opp. Rekkefølgen kallene blir ferdige i, er derfor en topologisk sortering av delinstansgrafen, med grunntilfellene først. En løsning nedenfra og opp går gjennom delinstansene i den samme rekkefølgen.
Sterke komponenter
En urettet graf er sammenhengende når det finnes en sti mellom hvert par av noder, og de sammenhengende komponentene er de største delene som er sammenhengende. DFS finner dem direkte: hvert dybde-først-tre er én komponent, for traverseringen fra en node stopper når det ikke er flere kanter å følge.
En rettet graf er sterkt sammenhengende når det for hvert par og finnes en sti fra til og en sti fra til . De sterke komponentene er de største mengdene av noder der alle kan nå alle. Kollapser du hver komponent til én node, får du komponentgrafen. Den er en DAG, for en sykel mellom to komponenter ville gjort dem til én.
Kjører du DFS rett på , kan et tre gå fra én komponent og inn i en annen. Starter DFS i en komponent der alle nodene er hvite og alle kantene ut av komponenten går til svarte noder, blir treet nøyaktig den komponenten. Du trenger derfor startnoder i en rekkefølge der hver komponent bare har kanter ut til komponenter som alt er besøkt. Sluttidene fra en første runde med DFS på gir en slik rekkefølge, men for den transponerte grafen og ikke for selv.
La sluttiden til en komponent være den høyeste sluttiden i den. Går en kant i fra komponent til en annen komponent , har høyere sluttid enn . Oppdager DFS en node i først, når den hele langs hvite stier før den noden blir ferdig. Oppdager den en node i først, kan den ikke nå derfra, for da ville og vært én komponent. Da er hele ferdig før blir oppdaget.
Komponenten med høyest sluttid har derfor ingen kanter inn fra andre komponenter i . Noden med lavest sluttid ligger derimot ikke nødvendigvis i en komponent uten kanter ut. Med kantene , og og DFS fra , som følger først, blir ferdig først, men komponenten har en kant ut til . Snur du alle kantene, får du den transponerte grafen , og der har komponenten ingen kanter ut. og har de samme sterke komponentene, for hver sti i den ene er en sti baklengs i den andre. Strongly-Connected-Components kjører derfor en runde til, på .
-
DFS på
Kjør DFS på for å finne sluttiden for hver node.
-
Snu kantene
Lag . Med nabolister tar det .
-
DFS på
Kjør DFS på , men la hovedløkka ta nodene etter synkende fra første runde.
-
Les av trærne
Hvert dybde-først-tre fra andre runde er én sterk komponent.
Andre runde starter i noden med høyest sluttid, og DFS besøker nøyaktig komponenten dens. Hver ny startnode har høyest sluttid av nodene som er igjen, og i fører kantene ut av komponenten dens bare til komponenter som alt er svarte. Hvert tre blir dermed én komponent, og hele algoritmen tar .
Koden bruker topological_sort ovenfor som første runde. Grafen kan ha sykler,
så lista er ikke en topologisk sortering, men den har fortsatt nodene etter
synkende sluttid.
def transpose(G):
  GT = {u: [] for u in G}
  for u in G:
      for v in G[u]:
          GT[v].append(u)
  return GT

def strongly_connected_components(G):
  order = topological_sort(G)
  GT = transpose(G)
  color = {u: "white" for u in G}
  components = []

  def visit(u, component):
      color[u] = "gray"
      component.append(u)
      for v in GT[u]:
          if color[v] == "white":
              visit(v, component)
      color[u] = "black"

  for u in order:
      if color[u] == "white":
          component = []
          visit(u, component)
          components.append(component)
return componentsGrafen fra forelesningen, med tidene d/f fra første runde ved hver node og lista order under grafen. I andre runde er kantene snudd, og et ferdig tre fra andre runde har grønn bakgrunn.
Hvordan kan antall sterke komponenter (strongly connected components) i en rettet graf endres hvis man legger til en ny kant? Forklar kort.
Vis løsning Skjul løsning
Antallet kan ikke øke, for en ny kant fjerner ingen stier. La den nye kanten være . Kan ikke nå , lager kanten ingen ny sykel, og ingenting endres. Kan nå , slås komponenten til , komponenten til og alle komponentene på stier fra til sammen til én. Det kan være mange: en rettet sti med noder har sterke komponenter, og kanten fra den siste noden til den første gjør stien til en sykel med én komponent.
Bredde-først-søk
Bredde-først-søk (BFS) bruker en FIFO-kø som huskeliste, så nodene som ble oppdaget først, besøkes først. BFS farger alle nodene hvite med , gjør startnoden grå med og legger den i køen. Så lenge køen ikke er tom, tas den første noden ut. Hver hvite nabo blir grå med og og settes bakerst i køen. Når alle naboene er sett, blir svart. I BFS teller kanter fra og er ikke en starttid som i DFS.
Avstanden er det minste antallet kanter på en sti fra til , og hvis ikke kan nås. Traverseringen går ut fra lag for lag. Hver kant som gjør grå, gir , så er lengden av stien fra til i bredde-først-treet. Ingen sti er kortere enn , så .
Køen er FIFO, og en node som settes inn, får én høyere enn noden som ble tatt ut. Nodene tas derfor ut i stigende , og køen har aldri mer enn to verdier av .
At , viser du med induksjon på avstanden . Har alle nodene med avstand fått , har en node med en kant inn fra en node med avstand . Når tas ut, er hvit og får , eller den er alt oppdaget av en node som ble tatt ut før , og da er .
Når BFS er ferdig, er altså (). Forgjengerkantene danner et bredde-først-tre, og stien i treet fra til er en korteste vei. Print-Path skriver den ut ved å følge forgjengerne bakover fra og skrive ut nodene på vei ut av rekursjonen.
from collections import deque

def bfs(G, s):
  color = {u: "white" for u in G}
  d = {u: float("inf") for u in G}
  pi = {u: None for u in G}
  color[s] = "gray"
  d[s] = 0
  Q = deque([s])
  while Q:
      u = Q.popleft()
      for v in G[u]:
          if color[v] == "white":
              color[v] = "gray"
              d[v] = d[u] + 1
              pi[v] = u
              Q.append(v)
      color[u] = "black"
  return d, pi

def print_path(pi, s, v):
  if v == s:
      print(s)
  elif pi[v] is None:
      print("ingen sti fra", s, "til", v)
  else:
      print_path(pi, s, pi[v])
print(v)Den samme grafen som for DFS, med startnode 1. Tallet ved hver node er , og forgjengerkantene har et bånd. Under grafen står alle nodene som har vært i køen , og de som er tatt ut, er bleke. De siste stegene viser stien print_path skriver ut til noden lengst unna.
Ta grafen fra forelesningen, den første grafen i begge stepperne. DFS fra node 1 når node 4 via 2, 3, 7 og 8, fem kanter fra 1, mens BFS når den med to, langs og . DFS følger én sti så langt den kan og kan oppdage en node via en omvei før den undersøker den korte kanten, så dybde-først-treet gir ikke nødvendigvis korteste vei.
Hver node settes i køen høyst én gang, for den blir grå idet den settes inn, og nabolista til en node gås gjennom én gang, når noden tas ut. BFS bruker derfor . DFS starter fra alle nodene og bruker alltid , mens BFS bare starter i . Har ingen kanter ut, er det bare initialiseringen igjen, og den tar .
| Algoritme | Verste | Beste |
|---|---|---|
| DFS | ||
| BFS | ||
| Topological-Sort | ||
| Strongly-Connected-Components |
Traversering med andre huskelister
Huskelista i BFS er køen . Nodene er hvite før de settes inn, grå mens de står i køen og svarte etterpå. FIFO-køen gjør at BFS finner korteste veier, men traverseringen besøker alle nodene som kan nås fra uansett hvilken node som tas ut i hver runde.
Bytter du bare køen med en stakk, blir traverseringen ikke DFS-Visit. Ta kantene , , og . BFS med stakk gjør og grå idet legger dem på stakken, så begge får forgjengeren , og når besøkes, er alt grå. DFS-Visit går fra til og kaller seg selv på fra , så får forgjengeren . DFS-Visit gjør en node grå først når kallet på den starter, og ikke når noden oppdages. Versjonen under venter på samme måte og gjør en node grå først når den kommer øverst i stakken.
Løkka ser på noden øverst i stakken. Er den hvit, blir den grå, og alle de hvite naboene legges på stakken. Er den ikke hvit, er alt som ble lagt over den, tatt av igjen, så den blir svart og tas av. En node kan ligge i stakken flere ganger. Den besøkes fra kopien som ble lagt på sist, og forgjengeren er noden som la den der. Naboene besøkes i motsatt rekkefølge av DFS-Visit, og stakken kan bli lang.
def iter_dfs_visit(G, s):
  color = {u: "white" for u in G}
  pi = {u: None for u in G}
  S = [s]
  while S:
      u = S[-1]
      if color[u] != "white":
          color[u] = "black"
          S.pop()
          continue
      color[u] = "gray"
      for v in G[u]:
          if color[v] == "white":
              pi[v] = u
              S.append(v)
  return pi
BFS prioriterer de eldste nodene i huskelista, og DFS de nyeste. Med en prioritetskø kan du prioritere etter noe annet, og da får du andre algoritmer. Prims algoritme for minimale spenntrær og Dijkstras algoritme for korteste vei er traverseringer av dette slaget, der nøklene i køen oppdateres underveis. Med en binær haug koster hver køoperasjon , og traverseringen tar når alle nodene kan nås fra .
Du prøver å implementere BFS for urettede grafer, men på grunn av en kodefeil, er rekkefølgen på nodene i køen din ikke lenger FIFO, men helt vilkårlig. Kan du nå være sikker på å besøke alle nodene? Forklar.
Vis løsning Skjul løsning
Hver node som oppdages, legges i køen, og traverseringen stopper ikke før køen er tom, så alt som legges i køen, blir besøkt. Anta at en node som kan nås fra , aldri blir besøkt, og se på en sti fra til . Den første noden på stien som ikke blir besøkt, har en nabo foran seg på stien som blir besøkt. Da ble den oppdaget og lagt i køen, og det er en motsigelse. Rekkefølgen avgjør bare når hver node besøkes. Det som går tapt, er korteste vei: er ikke lenger nødvendigvis avstanden fra .