Merge-Sort bruker tid, og ingen algoritme som bare sammenligner elementer parvis, kan gjøre det bedre i verste tilfelle. Grensen gjelder så lenge algoritmen bare sammenligner, og svaret skal være hele den sorterte tabellen. Ber du om mindre enn en sortert tabell, for eksempel bare det -ende minste elementet, eller antar du mer om inputen, for eksempel at verdiene er små heltall, går det i lineær tid.
Sorteringsgrensen
Insertion-Sort, Merge-Sort og Quicksort får bare vite noe om elementene gjennom tester som . De er sammenligningsbaserte. Hver test har to utfall, så alt en slik algoritme kan gjøre på elementer, kan tegnes som et binært tre. Hver indre node er en sammenligning, hver løvnode er en ferdig rekkefølge, og én kjøring er stien fra rota til en løvnode.
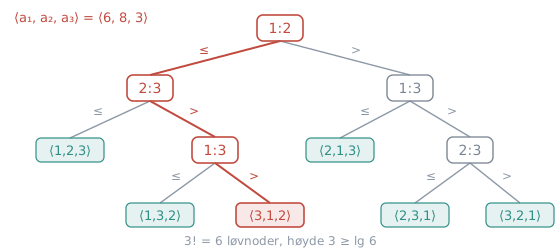
Tre elementer kan stå i rekkefølger, og hver av dem må være en løvnode. Et binært tre med høyde 2 har plass til bare fire løvnoder, så minst én input krever tre sammenligninger.
Generelt må treet ha en løvnode for hver av de permutasjonene av inputen, for hver av dem er riktig svar for en eller annen input. Et binært tre med høyde har høyst løvnoder, så og . Høyden er antall sammenligninger langs den lengste stien, altså i verste tilfelle. Stirlings formel gir , og dermed
Grensen er en nedre grense for verste tilfelle. Den sier at den dyreste instansen krever minst sammenligninger, og . Mer sier den ikke. En algoritme kan gjerne være verre, og i beste tilfelle kan den være bedre: Insertion-Sort bruker på sortert input. Beste tilfelle er uansett, for hvert element må leses. Gjennomsnittet er som det verste, for en tilfeldig permutasjon krever i snitt ja/nei-svar å skille fra de andre.
De følgende to trinnene utgjør tilsammen en sammenligningsbasert sorteringsalgoritme (comparison sort), som sorterer en tabell med elementer:
1 Init(A, n)
2 Main(A, n)
Kjøretiden til Main er . Hva er kjøretiden til Init i verste tilfelle?
Om du har en usortert tabell av lengde og først kjører Init(, ) og deretter Main(, ), vil altså ende opp sortert, og både Init og Main baserer seg kun på å sammenligne elementene i .
Vis løsning Skjul løsning
Init og Main til sammen er en sammenligningsbasert sortering, så summen av kjøretidene deres er i verste tilfelle. Main bidrar bare med , som er mindre enn det. Resten må Init stå for.
Randomized-Select
Det -ende minste elementet i en tabell har rang . Rang 1 er minimum, rang maksimum, og medianen har rang , den nederste av de to midterste når er partall. Sortering og oppslag finner elementet i , men du ber om mindre enn en sortert tabell, så sorteringsgrensen gjelder ikke. Verdiene antas å være forskjellige.
Randomized-Select er Quicksort med ett rekursivt kall. Randomized-Partition velger en tilfeldig pivot og setter den på plass , og da er pivoten det -ende minste i segmentet. Er , er pivoten svaret. Er , ligger svaret blant de små, og du søker etter rang der. Ellers ligger det blant de store, og der har det rang , for elementer er allerede mindre. Som i binærsøk stopper du straks du treffer, og søker bare videre i én av delene.
from random import randint

def randomized_partition(A, p, r):
  j = randint(p, r)
  A[j], A[r] = A[r], A[j]
  return partition(A, p, r)

def randomized_select(A, p, r, i):
  if p == r:
      return A[p]
  q = randomized_partition(A, p, r)
  k = q - p + 1
  if i == k:
      return A[q]
  elif i < k:
      return randomized_select(A, p, q - 1, i)
  else:
return randomized_select(A, q + 1, r, i - k)Søylene er tabellen, og målet er medianen, rang . Markøren står på plassen medianen har i sortert rekkefølge, og på pivotens plass. Det skyggelagte feltet er segmentet som er igjen, gule søyler er mindre enn pivoten og oransje større, og grønt er svaret.
Deler pivoten på midten hver gang, er : ett kall på halve instansen pluss lineært arbeid til delingen.
Finn løsningen med iterasjon, og verifiser med substitusjon. .
Vis løsning Skjul løsning
Iterasjon halverer leddet for hver ekspansjon:
Substitusjon: anta for alle . Da er , og stemmer.
Pivoten deler ikke på midten hver gang. Kall en pivot god når den har rang mellom og i segmentet på elementer. Da har begge sidene høyst elementer, så segmentet du søker videre i, har krympet til høyst av størrelsen. Halvparten av elementene er gode pivoter, så en tilfeldig pivot er god med sannsynlighet minst . Som når du kaster mynt til første kron, trengs da i forventning høyst to forsøk, altså to delinger, før segmentet krymper slik. Hver deling koster høyst lineær tid i segmentet, så forventet arbeid er høyst
Dette betyr at forventet kjøretid er for enhver input, ettersom regningen bare bruker de tilfeldige valgene og ikke rekkefølgen i inputen. Verste tilfelle er som for Quicksort. Havner pivoten ytterst hver gang, er , men det krever uflaks med de tilfeldige valgene, og ingen input er mer utsatt enn andre.
Din venn Lurvik har prøvd å skrive ned pseudokode for randomized select etter hukommelsen. Resultatet (algoritme 1) er ikke helt rett. Beskriv hva som må fikses for at algoritmen skal bli korrekt.
Randomized-Select(A, p, r, i)
1 if r ⩽ p
2     return A[p]
3 q = Randomized-Partition(A, p, r)
4 k = q − p + 1
5 if i == k
6     return A[q]
7 elseif i < k
8     Randomized-Select(A, p, q − 1, i)
9     Randomized-Select(A, q + 1, r, i − k)
Vis løsning Skjul løsning
De rekursive kallene på linje 8 og 9 kaster bort svaret sitt: verdien som
kommer tilbake, må returneres, så begge linjene trenger return foran.
Dessuten mangler linje 9 else. Uten else står begge kallene under
elseif: når , kjøres begge etter hverandre, og når , kjøres
ingen av dem.
8     return Randomized-Select(A, p, q − 1, i)
9 else return Randomized-Select(A, q + 1, r, i − k)
Betingelsen på linje 1 kan også strammes til if p == r, men den er ikke
feil slik den står.
return foran begge de rekursive kallene, og else først på linje 9.Select
Select fjerner tilfeldigheten og garanterer i verste tilfelle. Den bruker medianen av medianene til små grupper som pivot, og den pivoten ligger alltid nær midten.
-
Del i grupper på fem
Del de elementene i grupper med fem i hver, og sorter hver gruppe. Fem elementer sorteres i konstant tid, så det koster til sammen. Er ikke delelig med fem, flyttes det minste elementet fremst og telles bort først, opptil fire ganger.
-
Finn medianen av medianene
Hver gruppe har en median, det midterste av de fem. Kall Select rekursivt på de medianene og finn medianen av dem, .
-
Del rundt
Bytt inn bakerst og kjør Partition. Nå står på plass , og resten er som i Randomized-Select: svar, eller ett rekursivt kall på riktig side.
Garantien ligger i steg 2. Halvparten av gruppemedianene, av dem, er større enn eller lik . Hver av dem og de to elementene over den i gruppen er større enn eller lik , så minst elementer er større enn eller lik . På samme måte er minst elementer mindre enn eller lik . Det rekursive kallet i steg 3 får derfor høyst elementer.
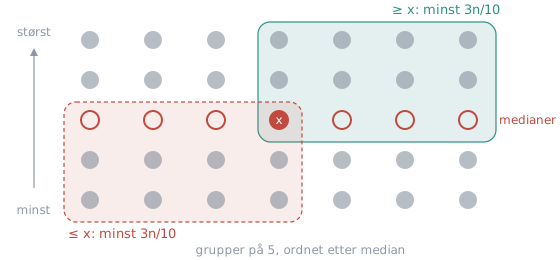
Steg 2 er et rekursivt kall på elementer, steg 3 et kall på høyst , og gruppesorteringen og Partition koster :
De to kallene får til sammen elementer, mindre enn , så arbeidet krymper geometrisk nedover i rekursjonstreet, og rota dominerer.
Verifiser med substitusjon
Anta for alle , og la det lineære arbeidet være høyst . Da er
så snart . Grunntilfellet ordnes ved å velge stor nok for de små verdiene av .
Select gir også de minste elementene i lineær tid: finn elementet med rang og del rundt det. Da står elementet på plass med de mindre til venstre for seg, og de første plassene holder de minste. Konstanten i Select er stor, så i praksis brukes Randomized-Select. Select viser likevel at rangering kan gjøres i lineær tid også i verste tilfelle.
Stabilitet og Counting-Sort
Select og Randomized-Select går under sorteringsgrensen ved å be om mindre enn en sortert tabell. Den andre veien er å anta mer om inputen: verdiene er heltall i et lite område . Da trenger du ikke sammenligne dem. Du kan bruke dem som indekser.
Elementer bærer ofte mer enn nøkkelen de sorteres på. Sorterer du en alfabetisk studentliste på karakter, kan studentene med samme karakter komme ut i en annen rekkefølge enn de sto i. En sorteringsalgoritme er stabil når like nøkler står i samme innbyrdes rekkefølge i output som i input, og da står studentene med samme karakter fortsatt alfabetisk. Når nøkkelen er hele elementet, spiller stabiliteten ingen rolle. Insertion-Sort og Merge-Sort er stabile når de skrives slik at et element flyttes bare forbi strengt større, og flettingen tar fra venstre ved likhet. Quicksort er det ikke, for Partition bytter elementer forbi hverandre.
Counting-Sort teller først hvor mange ganger hver verdi forekommer, . Så gjøres tellingen kumulativ, slik at er antall elementer som er mindre enn eller lik . I den sorterte tabellen står de elementene som er mindre enn , først, og -ene fyller plassene etter dem, til og med plass nummer . Til slutt går du baklengs gjennom : legg på plass nummer i , og trekk én fra . Neste like verdi havner ett hakk til venstre.
def counting_sort(A, n, k):
  B = [None] * n
  C = [0] * (k + 1)
  for j in range(n):
      C[A[j]] = C[A[j]] + 1
  for i in range(1, k + 1):
      C[i] = C[i] + C[i - 1]
  for j in range(n - 1, -1, -1):
      C[A[j]] = C[A[j]] - 1  # plass nummer c har indeks c - 1
      B[C[A[j]]] = A[j]
return BRadene er inputen med heltall i , tellingene og outputen . Like verdier har merker (2, 2′, 2″) så rekkefølgen kan følges, og de uthevede cellene er dem steget leser eller skriver.
Den baklengse løkka gjør algoritmen stabil. Den siste -en i behandles først og får den siste plassen i sin blokk, og hver tidligere legges til venstre for den. Rekkefølgen fra er bevart. Kjøretiden er , to løkker over og én over . Er , er kjøretiden lineær. Sorteringsgrensen brytes ikke, for ingen elementer sammenlignes. Verdiene brukes som indekser, og indekseringen krever at de er små heltall.
En av løkkene i Counting-Sort går fra ned til 1 (for downto 1). Hva er konsekvensen av å skifte retning på løkka (for to )?
Merk: Her kreves ingen forklaring.
Vis løsning Skjul løsning
Den siste løkka plasserer elementene bakfra, og det er det som gjør at like nøkler beholder rekkefølgen sin fra . Snur du løkka, plasseres like nøkler i motsatt rekkefølge av den de kom i.
Radix-Sort
Er verdiområdet stort, blir for stor. Men et tall med siffer har små nøkler. Radix-Sort sorterer stabilt på ett siffer om gangen, det minst signifikante først, med Counting-Sort med som subrutine for desimale siffer.
def radix_sort(A, n, d):
  for i in range(d):
      A = stable_sort_on_digit(A, n, i)  # Counting-Sort med k = 9
return AVenstre kolonne er tallene før passet, høyre kolonne outputen fra passet. Sifrene telles fra 0 bakfra som i koden, sifferet passet sorterer på er uthevet, og grønne siffer er ferdig behandlet.
Etter pass er tallene sortert på de siste sifrene. Denne invarianten holder ved induksjon, og induksjonssteget er stabiliteten. Pass nummer ordner tallene etter det -ende sifferet bakfra. To tall med ulikt siffer der havner dermed i riktig rekkefølge, og to tall med likt siffer beholder rekkefølgen fra før, som var sortert på de siste sifrene. Til sammen gir passet nøyaktig den rekkefølgen de siste sifrene gir.
Radix-Sort trenger begge deler: det minst signifikante sifferet først og en stabil subrutine. Starter du med det mest signifikante sifferet, ødelegger neste pass ordningen fra det forrige, for passet sorterer på et mindre viktig siffer uten å ta hensyn til det viktigere. Sorterer du 13 og 21 først på det fremste sifferet og så stabilt på det bakerste, ender du med 21, 13. Og er subrutinen ustabil, mister to tall med likt siffer ordningen fra de lavere sifrene.
Kjøretiden er pass med hver, altså . Er og konstanter, som for sekssifrede desimaltall, er kjøretiden lineær. Et siffer trenger ikke være et desimalsiffer. Datoer sorteres stabilt på dag, så måned, så år. Etter hvert pass er datoene sortert på feltene som er behandlet, med samme induksjonssteg som for sifrene.
Bucket-Sort
Bucket-Sort antar at inputen er tilfeldige tall, uniformt fordelt i . Del intervallet i like bøtter, og legg i bøtte nummer . Det er hashing med kjeding, men hashfunksjonen bevarer ordningen: alt i bøtte er mindre enn alt i bøtte . Sorter hver bøtte med Insertion-Sort, og sett bøttene etter hverandre.
def bucket_sort(A, n):
  B = [[] for _ in range(n)]
  for j in range(n):
      B[int(n * A[j])].append(A[j])
  for i in range(n):
      insertion_sort(B[i], len(B[i]))
  return [x for bucket in B for x in bucket]
Insertion-Sort på en bøtte med elementer koster , så det er forventningen av som avgjør, ikke at bøtta i snitt får ett element. Med uniform fordeling havner hvert element i bøtte med sannsynlighet , uavhengig av de andre, og da er . Summert over de bøttene er forventet arbeid i Insertion-Sort , så hele sorteringen tar forventet .
Forventningen til
Skriv , der når element havner i bøtte , og ellers . Da er , og og er uavhengige for , så
Forventningen her er et snitt over tilfeldige inputer, altså gjennomsnittstilfellet. Bucket-Sort gjør ingen tilfeldige valg selv, så en input der alt havner i én bøtte, gir alltid Insertion-Sort på hele inputen, . Randomized-Select og Randomized-Quicksort har forventet kjøretid over sine egne tilfeldige valg, for enhver input, og den garantien er sterkere.
| Algoritme | Forutsetning | Kjøretid |
|---|---|---|
| Randomized-Select | bare rang | forventet , verste |
| Select | bare rang | |
| Counting-Sort | heltall i | |
| Radix-Sort | siffer i | |
| Bucket-Sort | uniformt fordelt i | forventet , verste |